Содержание статьи
Помните этот классический мем?
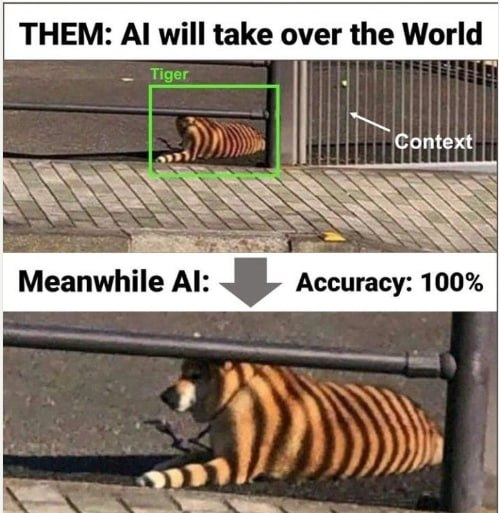
На картинке собака лежит за забором.
Полосы от ограждения падают на её тело.
Классический алгоритм компьютерного зрения уверенно рисует рамку и говорит:
Tiger. Accuracy: 100%.
И где-то в этот момент любой человек в комнате начинает смеяться.
Потому что для нас всё очевидно:
это не тигр, это собака;
полосы — не часть животного, а тень от забора;
забор — отдельный объект;
сцена происходит на улице;
и вообще тигры редко лежат у ворот бизнес-центра в ожидании обеда.
Но для старого компьютерного зрения это было не так очевидно.
Почему классический CV ошибался так смешно
Классическое компьютерное зрение долго жило в мире отдельных объектов.
Вот объект.
Вот рамка.
Вот класс.
Вот confidence score.
Система видит фрагмент изображения, находит визуальный паттерн и пытается сопоставить его с тем, что знает.
Полосы?
Похожи на тигра.
Форма тела?
Ну… допустим.
Контекст?
Какой контекст?
Именно поэтому старые CV-модели могли уверенно ошибаться там, где человек даже не задумывается. Они видели признаки, но не понимали сцену.
А в реальных задачах заказчиков это критично.
Потому что между “увидеть объект” и “понять, что происходит” — огромная разница.
Обнаружить каску — это не то же самое, что понять нарушение
Возьмём промышленную безопасность.
Классический детектор может найти каску.
Или не найти каску.
Или найти человека.
Или найти сигарету.
Или найти мобильный телефон.
Но бизнес-задача почти никогда не звучит так просто.
Заказчику нужно понять:
человек действительно находится в опасной зоне или просто проходит за ограждением?
работник нарушает регламент или выполняет штатную операцию?
машина движется опасно близко к человеку или они находятся в разных зонах?
сотрудник использует телефон в запрещенной зоне или держит рабочий терминал?
дерево находится внутри строительной площадки или за пределами защитного ограждения?
Это уже не просто object detection.
Это понимание отношений между объектами, пространственной логики, регламентов и контекста.
И вот здесь начинается самое интересное.
Новый этап: от распознавания к пониманию
Современные Vision-Language Models, или VLM, меняют саму логику работы компьютерного зрения.
Если классический CV отвечает на вопрос:
“Что на изображении?”
то VLM может отвечать на более сложные вопросы:
“Что здесь происходит?”
“Есть ли нарушение?”
“Почему это может быть опасно?”
“Какие объекты связаны между собой?”
“Соответствует ли сцена заданному правилу?”
Это уже не просто поиск рамок на изображении.
Это анализ сцены на уровне смысла.
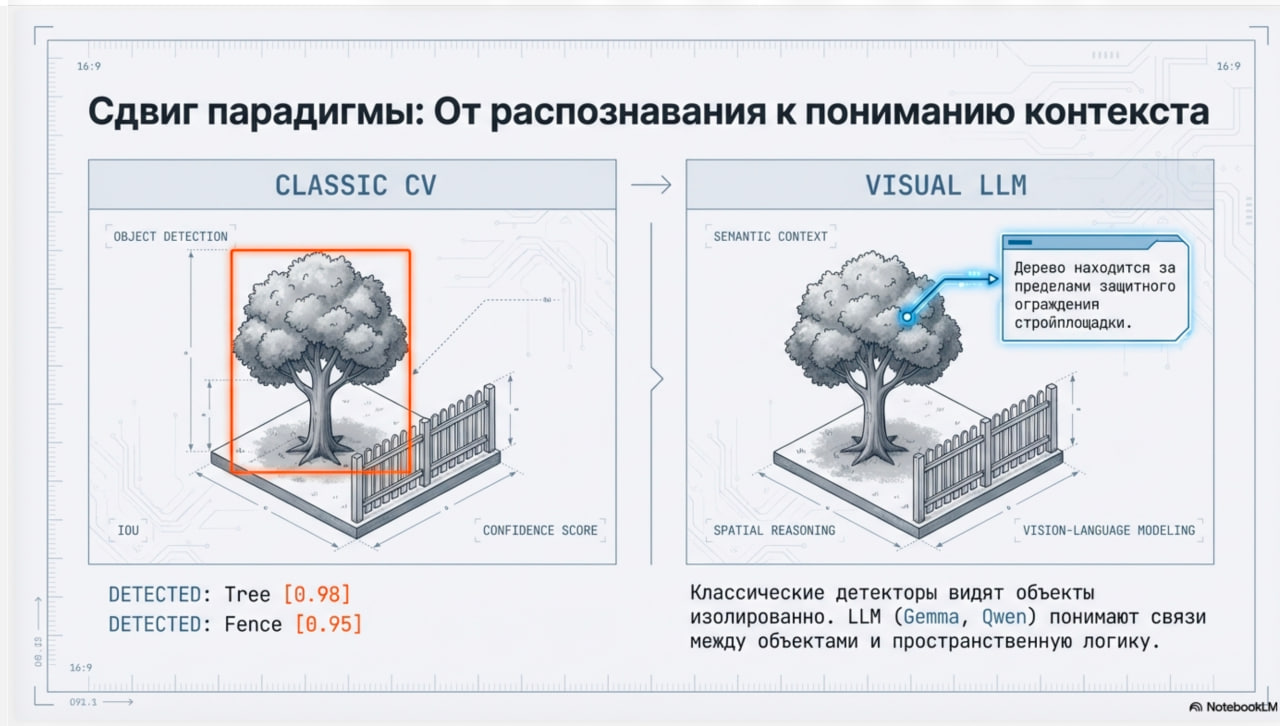
На простом примере с деревом и забором разница выглядит так:
Классический CV скажет:
“Detected: Tree. Detected: Fence.”
VLM скажет:
“Дерево находится за пределами защитного ограждения строительной площадки.”
И это принципиально другой уровень.
Потому что в реальном мире важно не только наличие объекта, но и его положение, роль и связь с другими объектами.
Что это меняет для заказчиков
Главное изменение даже не в том, что ИИ стал “умнее”.
Главное — в том, что он стал гораздо ближе к человеческому способу постановки задач.
Раньше создание нового детектора компьютерного зрения было отдельным проектом:
собрать данные;
разметить изображения;
обучить модель;
проверить качество;
доработать;
снова собрать данные;
снова разметить;
снова обучить.
Это занимало недели или месяцы.
Теперь часть задач можно формулировать иначе — через описание правила на естественном языке.
Например:
“Определи, находится ли человек в опасной зоне без защитной каски.”
“Проверь, пересекает ли сотрудник красную линию рядом с работающей техникой.”
“Найди случаи, когда водитель отвлекается от дороги.”
“Определи, находится ли посторонний человек за рабочим местом диспетчера.”
“Проверь, курит ли сотрудник в зоне, где курение запрещено.”
Конечно, магии здесь нет. Для промышленных сценариев всё равно нужны тестирование, настройка, контроль качества и валидация. Но сам процесс создания новых сценариев становится быстрее, гибче и понятнее для бизнеса.
Как это реализовано в VizorLabs
В нашей платформе VizorLabs мы уже встроили ИИ нового поколения на базе VLM.
Это позволяет системе не просто распознавать отдельные объекты, а анализировать сцену с учетом контекста: где находится человек, что он делает, какие объекты рядом, есть ли нарушение заданного правила и почему система считает это событием.
Самое важное — заказчик получает возможность создавать новые сценарии видеоаналитики самостоятельно.
Не через долгий цикл разработки кастомной модели.
Не через отдельный проект на месяцы.
Не через бесконечные согласования “а можно ли добавить ещё один детектор”.
А через встроенный редактор промптов в платформе.
Пользователь описывает правило человеческим языком, настраивает логику, проверяет результат на видеопотоке или архиве — и получает новый сценарий анализа.
Это особенно важно для предприятий, где регламенты постоянно меняются, а число потенциальных ситуаций слишком велико, чтобы заранее обучить отдельную модель под каждую.
Почему это не отменяет классические детекторы
Здесь важно не уйти в другую крайность.
VLM — это не замена всему классическому компьютерному зрению.
Классические детекторы по-прежнему отлично подходят для задач, где нужно быстро, стабильно и массово распознавать типовые объекты: людей, каски, жилеты, транспорт, зоны, спецтехнику, сигареты, телефоны.
Но VLM добавляет недостающий слой — слой понимания.
Идеальная архитектура сегодня выглядит не как “старое против нового”, а как комбинация:
классические CV-модели быстро находят объекты и события;
VLM анализирует контекст, связи и смысл;
правила предприятия превращаются в понятные сценарии;
оператор получает не просто тревогу, а объяснимое событие.
Именно такая связка позволяет снизить количество нелепых ошибок в стиле “собака стала тигром”.
Немного провокации
Мем про “AI will take over the world” был смешным, потому что ИИ действительно часто не понимал очевидных вещей.
Но сейчас он становится смешным уже по другой причине.
Потому что современные модели начинают понимать контекст лучше, чем многие ожидали.
Они уже не просто считают полоски на собаке.
Они смотрят на сцену целиком.
И это меняет рынок видеоаналитики.
Раньше заказчик спрашивал:
“Можно ли обучить детектор под нашу задачу?”
Теперь вопрос всё чаще звучит иначе:
“Можно ли описать наш регламент так, чтобы система сама начала его проверять?”
И вот это, на мой взгляд, гораздо более сильный сдвиг, чем очередной процент точности в презентации.
Вместо вывода
Компьютерное зрение прошло путь от “я вижу объект” к “я понимаю ситуацию”.
Сначала мы учили ИИ находить каску.
Потом — человека без каски.
Потом — человека без каски в опасной зоне.
Теперь — нарушение конкретного регламента в конкретном контексте предприятия.
И это уже совсем другая история.
Так что если вы всё ещё используете старый мем про собаку-тигра как доказательство ограниченности ИИ — используйте осторожно.
Современный ИИ может посмотреть на эту картинку и сказать:
“Это собака. Полосы образованы тенью от забора. Вероятность тигра крайне низкая.”
А потом, возможно, добавит:
“Но мем всё равно хороший.”
