MLLM — контекстная видеоаналитика и AI-агенты
Промышленная видеоаналитика VizorLabs
Мультимодальные языковые модели обогащают события визуальным контекстом, помогают анализировать нарушения и создавать проверяемые черновики сценариев на естественном языке.
Статус возможностей. Ниже описаны сценарии MLLM и направления развития. Расширенный контекст событий, чат-аналитика и AI-агенты относятся к концепции развития Platform 4.0; доступность каждой функции подтверждается для конкретного проекта.
Интеллектуальный контур Платформы 4.0
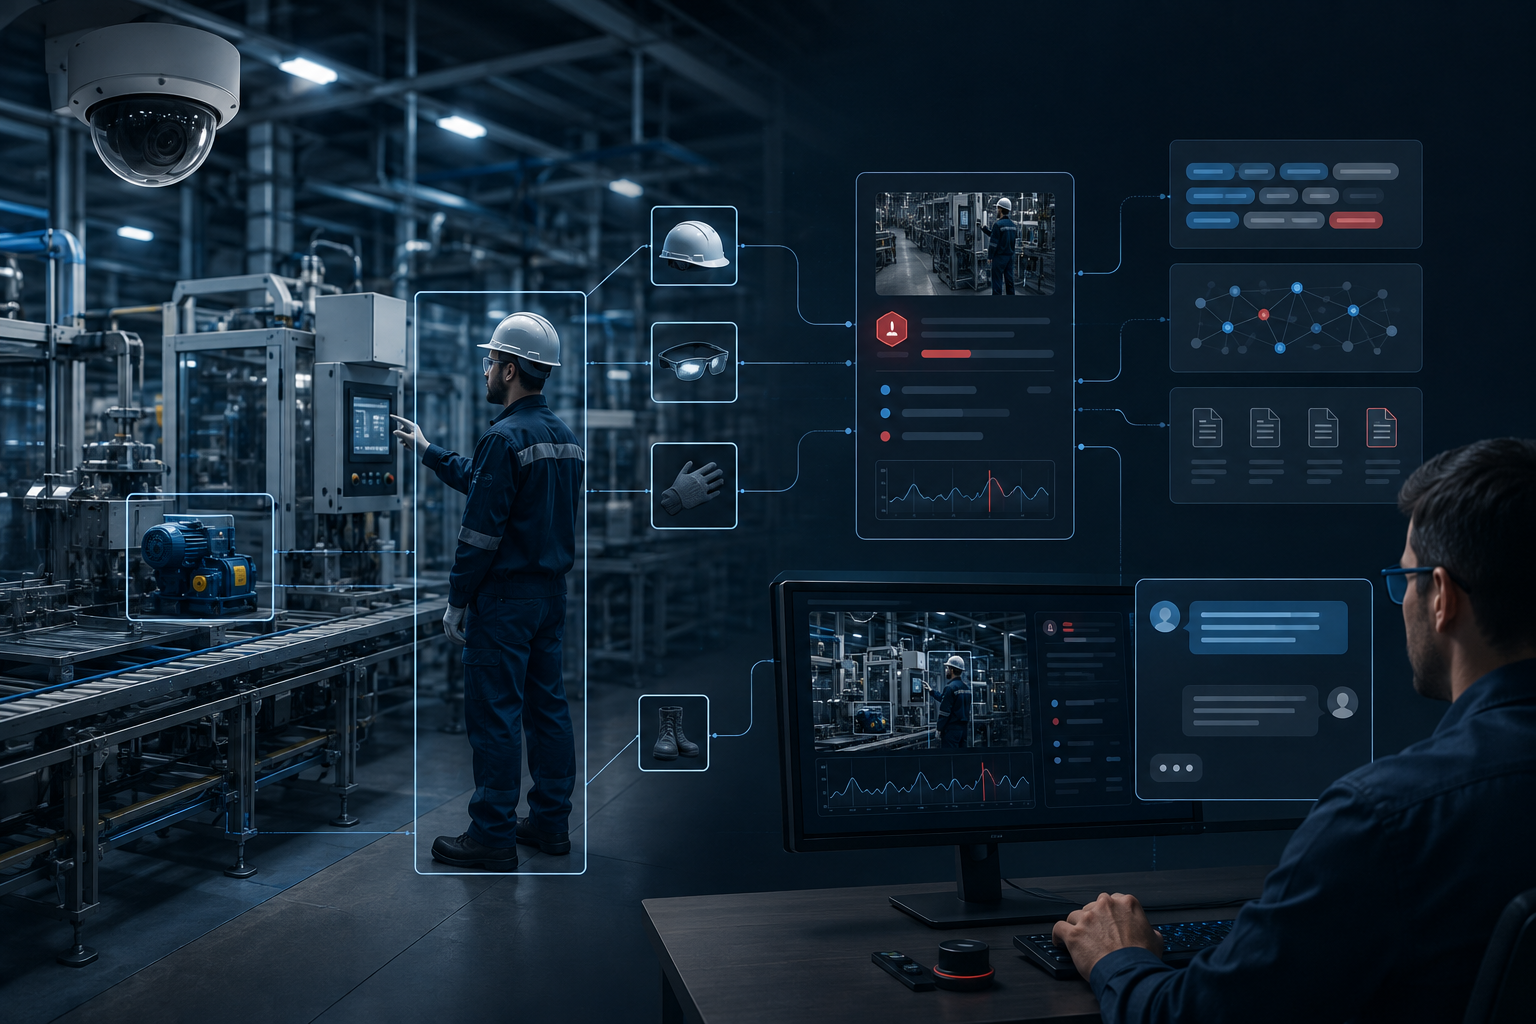
MLLM-контур развивает промышленную видеоаналитику от фиксации события к пониманию его контекста. Платформа помогает ответить на три вопроса: что произошло, почему это важно и какие действия следует проверить ответственному пользователю.
Контекст события
После срабатывания детектора или сценария мультимодальная языковая модель может анализировать изображение или видеофрагмент вместе с типом нарушения, камерой, рабочей зоной, справочниками и доступной нормативной базой предприятия. Результат сохраняется в карточке события в виде пояснения, тегов, факторов риска, ссылок на применимые нормы, уровня уверенности и рекомендаций оператору.
Диалоговая аналитика
Чатовый интерфейс позволяет формулировать запросы к журналам событий естественным языком: находить повторяющиеся нарушения, сравнивать объекты и периоды, объяснять динамику показателей и формировать управленческие сводки с переходом к исходным карточкам.
AI-агенты для сценариев
Пользователь описывает требуемую логику контроля, а AI-агент формирует черновик low-code сценария: предлагает модели и блоки, зоны, условия, параметры, выходное событие и схему тестирования. Агент может запускать проверку на тестовых материалах, собирать метрики и предлагать доработки.
Контролируемое применение
- Human-in-the-loop: значимые выводы и публикации подтверждает человек.
- Трассируемость: сохраняются версия модели и промпта, входные данные и источники вывода.
- Ролевая безопасность: AI-функции наследуют права пользователя.
- Проверка до production: AI-сгенерированный сценарий проходит тестирование и утверждение.
- Разделение фактов и интерпретаций: результаты детекторов, выводы MLLM и гипотезы отображаются отдельно.
MLLM-возможности внедряются поэтапно; доступный состав функций и требования к вычислительному контуру определяются конфигурацией проекта.
Как связаны детекторы, MLLM и база знаний
Детектор выделяет наблюдаемый признак, сценарий формирует событие, а мультимодальная модель может помочь описать его контекст. RAG добавляет к анализу найденные материалы из разрешённой базы знаний. Вывод модели проверяется по исходному кадру, событию и использованным источникам.
Состав доступных MLLM-функций определяется проектом. Чат-аналитика, расширенный контекст событий и AI-агент подготовки сценариев описаны в концепции развития от 08.05.2026, а не как единый безусловно доступный релиз. Подробности — в руководствах MLLM и RAG и работа с карточкой события.
